وبلاگ
دیدگاههایی درباره سختافزار هوش مصنوعی
راهنماها، مقایسهها و دیدگاههایی درباره کارتهای گرافیک و زیرساخت LLM محلی.
مقایسهها
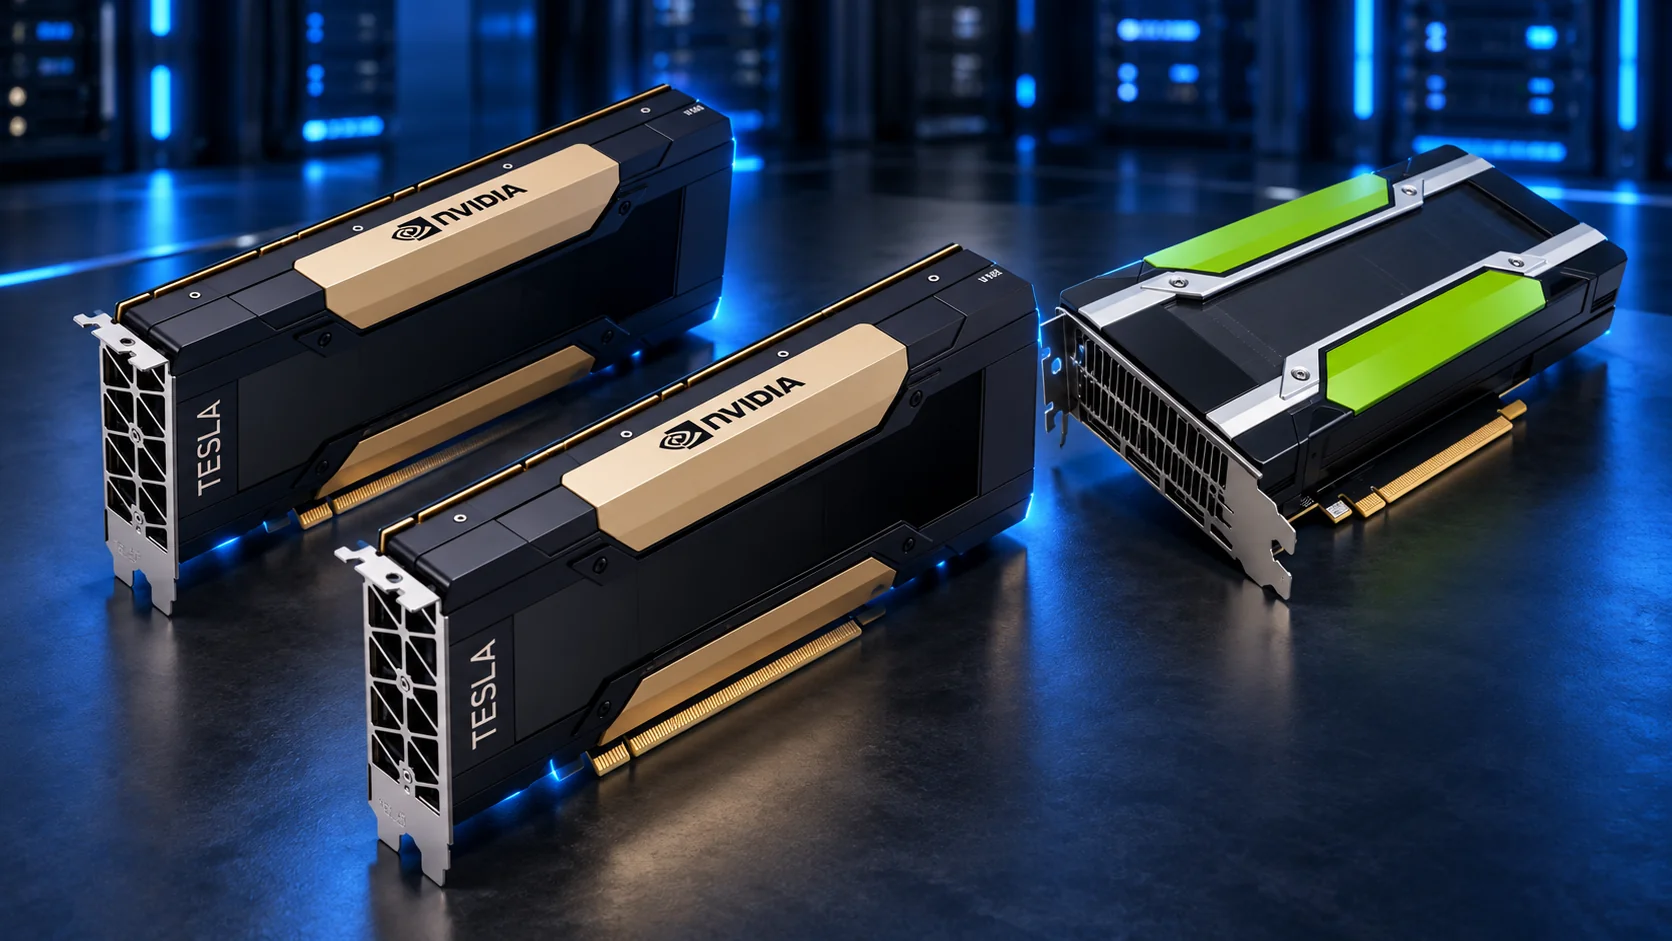
مقایسه NVIDIA Tesla V100 32GB، V100 16GB و Tesla P40 24GB: کدام GPU برای اجرای محلی LLM در سال 2026 بهتر است؟
کارت گرافیکی که حافظه بیشتری دارد، بهطور خودکار پاسخها را سریعتر تولید نمیکند. پهنای باند حافظه، معماری پردازشی، سازگاری نرمافزاری و کوانتیزهسازی مدل همگی بر عملکرد در دنیای واقعی تأثیر میگذارند.
راهنماها
چگونه برای اجرای مدلهای زبانی بزرگ (LLM) کارت گرافیک انتخاب کنیم
پیش از انتخاب کارت گرافیک برای یک مدل زبانی بزرگ چه چیزهایی را بررسی کنیم: حافظه، تخمین سریع حافظهی لازم، پهنای باند، قالبهای عددی، نرمافزار و خنککاری.
پرسشی درباره زیرساخت هوش مصنوعی خود دارید؟
با کارشناسان ما صحبت کنید
برای زیرساخت هوش مصنوعی خود مشاوره شخصی بگیرید.
مشاوره با ما →