مقایسهها
مقایسه NVIDIA Tesla V100 32GB، V100 16GB و Tesla P40 24GB: کدام GPU برای اجرای محلی LLM در سال 2026 بهتر است؟
کارت گرافیکی که حافظه بیشتری دارد، بهطور خودکار پاسخها را سریعتر تولید نمیکند. پهنای باند حافظه، معماری پردازشی، سازگاری نرمافزاری و کوانتیزهسازی مدل همگی بر عملکرد در دنیای واقعی تأثیر میگذارند.
از Effecsa GPU
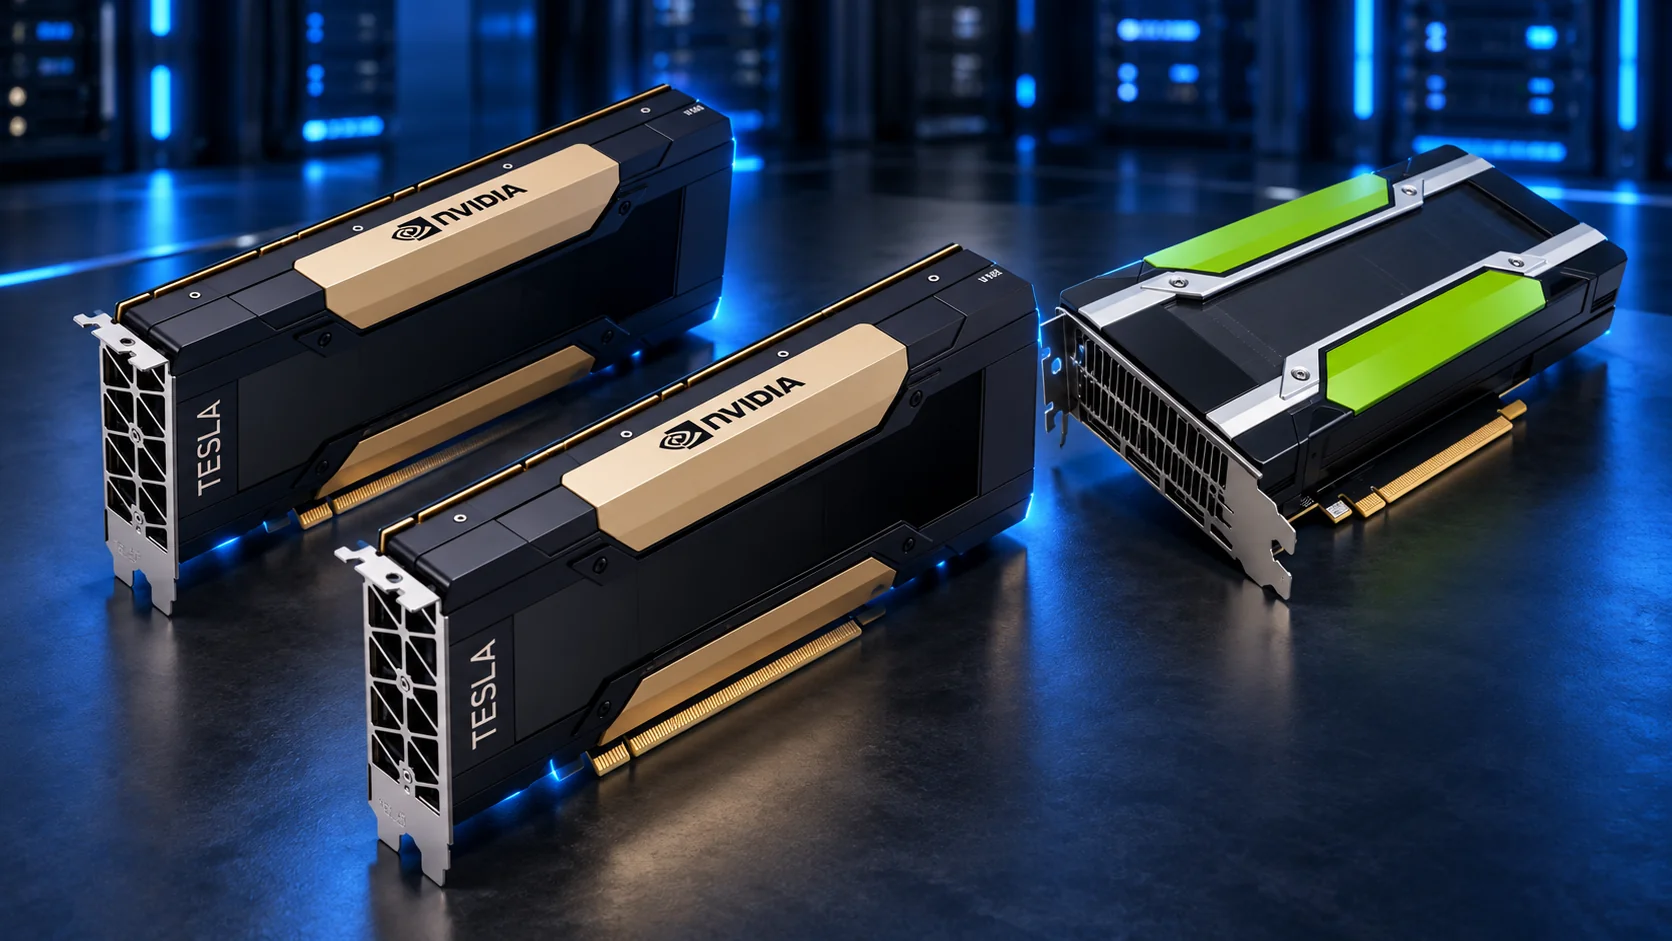
اجرای محلی مدلهای زبانی بزرگ لزوماً به جدیدترین کارت گرافیک NVIDIA نیاز ندارد. کارتهای گرافیک قدیمیتر دیتاسنتری مانند Tesla V100 32GB، Tesla V100 16GB و Tesla P40 24GB همچنان میتوانند برای آزمایشهای هوش مصنوعی، سرورهای استنتاج خصوصی و مدلهای زبانی با میزبانی شخصی مفید باشند.
اما انتخاب میان آنها به سادگی مقایسه VRAM نیست.
کارت گرافیکی که حافظه بیشتری دارد، بهطور خودکار پاسخها را سریعتر تولید نمیکند. پهنای باند حافظه، معماری پردازشی، سازگاری نرمافزاری و کوانتیزهسازی مدل همگی بر عملکرد در دنیای واقعی تأثیر میگذارند.
در این راهنما، این سه کارت گرافیک NVIDIA را مقایسه میکنیم، نقاط قوت و محدودیتهای آنها را توضیح میدهیم و نشان میدهیم چگونه عملکردشان را برای استنتاج محلی LLM بنچمارک کنید.
1. مقایسه NVIDIA Tesla V100 و P40: مشخصات
پیش از بررسی بارهای کاری هوش مصنوعی، مهم است بدانیم چه ویژگیهایی این کارتهای گرافیک را از یکدیگر متمایز میکنند.
| مشخصه | Tesla V100 32GB | Tesla V100 16GB | Tesla P40 24GB |
|---|---|---|---|
| معماری | Volta | Volta | Pascal |
| حافظه GPU | 32GB HBM2 | 16GB HBM2 | 24GB GDDR5 |
| پهنای باند حافظه | 900 GB/s | 900 GB/s | 346 GB/s |
| هستههای CUDA | 5,120 | 5,120 | 3,840 |
| هستههای Tensor | 640 | 640 | ندارد |
| عملکرد FP32 (PCIe) | 14 TFLOPS | 14 TFLOPS | 12 TFLOPS |
| قابلیت محاسباتی | 7.0 | 7.0 | 6.1 |
| رابط PCIe | PCIe 3.0 | PCIe 3.0 | PCIe 3.0 |
| حداکثر توان برد | 250W | 250W | 250W |
مشخصات به نسخههای PCIe کارت Tesla V100 مربوط هستند. NVIDIA ماژولهای V100 با فرم SXM2 را نیز تولید کرده است که ویژگیهای متفاوتی از نظر توان و ارتباط میان پردازندهها دارند.
تفاوت اصلی: کارت V100 پهنای باند حافظه بسیار بالاتر و هستههای اختصاصی Tensor دارد، در حالی که P40 با ارائه 24GB حافظه، ممکن است امکان اجرای مدلهای کوانتیزهشده بزرگتری را نسبت به V100 16GB فراهم کند.
این تفاوتهای معماری هنگام اجرای موتورهای استنتاج مدرن LLM اهمیت پیدا میکنند.
2. شناخت عملکرد GPU برای اجرای محلی LLM
هنگام ارزیابی کارتهای گرافیک برای مدلهای زبانی، چهار عامل شایسته توجه ویژه هستند.
VRAM: چه مدل بزرگی را میتوانید اجرا کنید؟
VRAM مشخص میکند چه مقدار از یک مدل زبانی میتواند در حافظه GPU باقی بماند.
برای مثال، مدلی با 8 میلیارد پارامتر، تنها برای وزنهای خام FP16 خود به حدود 16GB حافظه نیاز دارد. کوانتیزهسازی میتواند این نیاز را بهطور چشمگیری کاهش دهد.
به همین دلیل اجرای مدلهای کوانتیزهشده با قالبهایی مانند Q4 یا Q5 روی کارتهای گرافیک قدیمیتر رایج است.
برای استنتاج محلی:
- 16GB VRAM: نقطه شروعی عملی برای LLMهای کوانتیزهشده کوچکتر و متوسط.
- 24GB VRAM: فضای بیشتری برای مدلهای بزرگتر، زمینههای طولانیتر و بارهای کاری استنتاج فراهم میکند.
- 32GB VRAM: انعطافپذیری بیشتری برای مدلهای کوانتیزهشده بزرگتر و پنجرههای زمینه طولانیتر فراهم میکند.
به یاد داشته باشید که وزنهای مدل تنها مصرفکننده حافظه نیستند. استنتاج برای کش KV، بافرهای زمان اجرا و عملیات دیگر نیز از حافظه استفاده میکند.
پهنای باند حافظه: دادهها با چه سرعتی جابهجا میشوند؟
پهنای باند حافظه بهویژه هنگام تولید خودرگرسیو توکن اهمیت دارد؛ فرایندی که در آن باید به وزنهای مدل بهطور مکرر دسترسی داشت.
کارت Tesla V100 تا 900 GB/s پهنای باند HBM2 ارائه میدهد، در حالی که این مقدار در Tesla P40 برابر با 346 GB/s است.
این ویژگی برای V100 در عملیات وابسته به حافظه، مزیت نظری قابلتوجهی ایجاد میکند.
با این حال، پهنای باند بالاتر افزایش معادل در تعداد توکن بر ثانیه را تضمین نمیکند. سرعت واقعی به مدل، قالب کوانتیزهسازی، کرنلهای GPU و موتور استنتاج بستگی دارد.
هستههای Tensor: یک مزیت معماری مهم
کارت Tesla V100 دارای 640 هسته Tensor نسل اول NVIDIA است که میتوانند عملیات ماتریسی پشتیبانیشده را، بهویژه در بارهای کاری با دقت ترکیبی، تسریع کنند.
کارت P40 هسته Tensor ندارد. در عوض، برای نسل قدیمیتری از بارهای کاری استنتاج، از جمله عملیات شتابیافته INT8، طراحی شده است.
اگرچه مشخصات تاریخی INT8 کارت P40 چشمگیر هستند، نباید این ارقام را با عملکرد اجرای یک مدل زبانی کوانتیزهشده مدرن 4 بیتی اشتباه گرفت.
برای استنتاج مدرن LLM، پیادهسازی نرمافزاری به اندازه عملکرد نظری GPU اهمیت دارد.
سازگاری نرمافزاری
هر دو کارت گرافیک معماری قدیمیتری دارند.
کارت V100 از قابلیت محاسباتی CUDA نسخه 7.0 استفاده میکند، در حالی که این مقدار برای P40 برابر با 6.1 است. مستندات سازگاری NVIDIA، نسل CUDA 12.x را آخرین نسل ابزار توسعه پشتیبان هر دو معماری و شاخه درایور R580 را آخرین شاخه درایور پشتیبانیشده آنها معرفی میکند.
این موضوع بهویژه در سال 2026 اهمیت دارد.
هر چارچوب جدید هوش مصنوعی یا بسته ازپیشساخته CUDA روی این کارتهای گرافیک کار نخواهد کرد. پیش از انتخاب محیط اجرا یا ارتقای محیط خود، پشتیبانی از معماری را بررسی کنید.
3. کدام مدلهای LLM روی هر کارت گرافیک اجرا میشوند؟
یکی از رایجترین پرسشها این است: در عمل، چه مدل زبانی با چه اندازهای را میتوانم اجرا کنم؟
پاسخ به کوانتیزهسازی، طول زمینه، اندازه دسته و این موضوع بستگی دارد که آیا مدل بهطور کامل در VRAM بارگذاری میشود یا نه.
جدول زیر نقطه شروعی عملی برای اندازههای رایج مدلهای زبانی متراکم با کوانتیزهسازی تقریباً 4 بیتی ارائه میدهد.
| اندازه مدل | V100 16GB | P40 24GB | V100 32GB |
|---|---|---|---|
| 7B–8B Q4 | مناسب | مناسب | مناسب |
| 13B–14B Q4 | معمولاً مناسب | مناسب | مناسب |
| 30B–32B Q4 | عموماً برای انتقال کامل پردازش به GPU بیش از حد بزرگ است | امکانپذیر، وابسته به حافظه | عموماً مناسب |
| 70B Q4 | نیازمند انتقال بخش قابلتوجهی از پردازش به CPU یا استفاده از چند GPU | نیازمند انتقال بخش قابلتوجهی از پردازش به CPU یا استفاده از چند GPU | نیازمند انتقال بخشی از پردازش به CPU یا استفاده از چند GPU |
این موارد ارزیابیهای تقریبی ظرفیت هستند، نه نتایج بنچمارک تأییدشده. جا شدن واقعی مدل به معماری مشخص مدل، فایل کوانتیزهسازی، کش KV و سربار زمان اجرا بستگی دارد.
برای مثال، یک مدل کوانتیزهشده 32B بسته به قالبش ممکن است فقط برای وزنهای مدل حدود 18–23GB فضا اشغال کند. کارت P40 با حافظه 24GB ممکن است برخی پیکربندیها را در خود جای دهد، اما حافظه باقیمانده برای زمینه و بافرهای زمان اجرا محدود باشد.
کارت V100 32GB فضای آزاد بیشتری فراهم میکند و به همین دلیل گزینه انعطافپذیرتری برای آزمایش مدلهای بزرگتر است.
4. مقایسه Tesla V100 32GB و 16GB: آیا VRAM بیشتر به معنای سرعت بالاتر است؟
یک تصور اشتباه رایج این است که V100 32GB باید دو برابر V100 16GB سریع باشد.
استنتاج روی GPU به این شکل کار نمیکند.
در مدلهای PCIe قابلمقایسه، هر دو کارت معماری Volta، تعداد هستههای CUDA، تعداد هستههای Tensor و پهنای باند اسمی حافظه یکسانی دارند.
بنابراین، هنگام اجرای یک مدل یکسان با تنظیمات یکسان که بهطور کامل روی هر یک از این دو GPU جا میشود، عملکرد ممکن است نسبتاً مشابه باشد.
مزیت نسخه 32GB زمانی پررنگتر میشود که نیاز یک بار کاری از 16GB فراتر برود.
با حافظه بیشتر، V100 بزرگتر میتواند:
- مدلهای زبانی کوانتیزهشده بزرگتر را بهطور کامل روی GPU اجرا کند.
- در صورت وجود حافظه کافی برای کش KV، از پنجرههای زمینه طولانیتر پشتیبانی کند.
- نیاز به انتقال لایههای مدل به RAM سیستم را کاهش دهد.
- فضای آزاد حافظه بیشتری برای برخی بارهای کاری دستهای و چنددرخواستی فراهم کند.
ارزیابی ما: کارت V100 32GB گزینه انعطافپذیرتری برای آزمایش محلی LLM است، در حالی که نسخه 16GB زمانی همچنان مفید است که مدلهای موردنظر شما بهراحتی در حافظه آن جا شوند.
5. مقایسه Tesla P40 24GB و V100: کدام عملکرد بهتری دارد؟
کارت Tesla P40 گزینه جالبی است، زیرا با وجود استفاده از معماری قدیمیتر Pascal، نسبت به V100 16GB حافظه VRAM بیشتری ارائه میدهد.
برای بارهای کاریای که مدل در 16GB جا نمیشود اما در 24GB جا میگیرد، P40 ممکن است با جلوگیری از انتقال بخشی از پردازش به CPU، نسبت به V100 کوچکتر مزیتی عملی داشته باشد.
با این حال، زمانی که هر دو GPU بتوانند یک مدل یکسان را بهطور کامل بارگذاری کنند، پهنای باند بالاتر حافظه و سختافزار توانمندتر V100 در محاسبات با دقت ترکیبی، معمولاً آن را از نظر عملکرد به گزینه قویتری تبدیل میکنند.
مقایسه عملکرد GPU در یک نگاه
| کاربرد | GPU ترجیحی |
|---|---|
| LLMهای کوانتیزهشده کوچک | عموماً V100 |
| مدلهای بزرگتر با نیاز به بیش از 16GB | P40 یا V100 32GB |
| بیشترین حافظه تکGPU در میان این کارتها | V100 32GB |
| محاسبات هوش مصنوعی با دقت ترکیبی | V100 |
| سیستمهای اقتصادی 24GB در سطح پایه | P40، اگر هزینه و سازگاری آن را توجیه کنند |
کارت P40 برای پروژههایی که ظرفیت حافظه و هزینه تهیه سختافزار در آنها از حداکثر سرعت استنتاج مهمتر است، همچنان ارزش بررسی دارد.
اما نباید آن را جایگزینی مستقیم برای شتابدهندههای استنتاج جدیدتر دانست.
6. چگونه این GPUها را برای استنتاج LLM بنچمارک کنیم؟
مشخصات زمینه مفیدی برای شناخت سختافزار فراهم میکنند، اما یک بنچمارک منصفانه به اندازهگیریهای واقعی نیاز دارد.
برای دستیابی به نتایج تکرارپذیر، استفاده از llama.cpp را پیشنهاد میکنیم که ابزار اختصاصی بنچمارک به نام llama-bench را در خود دارد.
مرحله 1: آمادهسازی محیط
از یک محیط لینوکس پشتیبانیشده، درایور سازگار NVIDIA و زنجیرهابزار CUDA استفاده کنید که بتواند برای قابلیت محاسباتی GPU کامپایل کند.
برای سختافزارهای قدیمیتر Pascal و Volta، بررسی سازگاری اهمیت ویژهای دارد.
پس از نصب، بررسی کنید که GPU شناسایی شده باشد:
nvidia-smiنام GPU، حافظه در دسترس، نسخه درایور و وضعیت توان را بررسی کنید.
مرحله 2: انتخاب یک مدل مشترک
برای قابلمقایسه بودن نتایج، همه GPUها باید یک فایل مدل و کوانتیزهسازی یکسان را اجرا کنند.
یک نقطه شروع مناسب، مدل متراکم پشتیبانیشده 7B–8B با یک فایل Q4 GGUF است.
از مقایسه یک GPU که مدل 4 بیتی اجرا میکند با GPU دیگری که نسخه 8 بیتی را اجرا میکند، خودداری کنید. این کار نتایج گمراهکنندهای ایجاد میکند.
مرحله 3: اجرای llama-bench
با یک نسخه سازگار از llama.cpp که با پشتیبانی CUDA ساخته شده است، دستور زیر را اجرا کنید:
./build/bin/llama-bench \
  -m ./models/model-q4_k_m.gguf \
  -p 512 \
  -n 128 \
  -ngl 99 \
  -r 5
مسیر مدل را با مسیر فایل واقعی GGUF جایگزین کنید. مطمئن شوید GPU انتخابشده حافظه آزاد کافی برای پیکربندی موردنظر انتقال پردازش به GPU را دارد.
این بنچمارک عملکرد پردازش پرامپت و تولید متن را اندازهگیری میکند و نرخ پردازش را بر حسب توکن بر ثانیه گزارش میدهد.
مرحله 4: جمعآوری اندازهگیریهای تکمیلی
برای مقایسههای معنادار، موارد زیر را ثبت کنید:
- پردازش پرامپت (توکن بر ثانیه): GPU با چه سرعتی متن ورودی را پردازش میکند.
- تولید توکن (توکن بر ثانیه): با چه سرعتی توکنهای خروجی جدید تولید میکند.
- مصرف VRAM: بار کاری چه مقدار از حافظه GPU را مصرف میکند.
- توان مصرفی (وات): توان الکتریکی مصرفشده هنگام اجرا.
- طول زمینه: مقدار تاریخچه ورودی استفادهشده در آزمایش.
- نسخههای نرمافزار: درایور، CUDA، کامیت llama.cpp و کوانتیزهسازی مدل.
آزمایشها را در شرایط قابلمقایسه تکرار کنید. همچنین از خنککاری کافی اطمینان حاصل کنید، زیرا کاهش فرکانس ناشی از محدودیت حرارتی میتواند بر نتایج تأثیر بگذارد.
مرحله 5: ثبت نتایج واقعی بنچمارک
برای گزارشدهی شفاف از قالب زیر استفاده کنید:
| GPU | مدل | توکن پرامپت بر ثانیه | توکن تولیدشده بر ثانیه | اوج مصرف VRAM |
|---|---|---|---|---|
| V100 32GB | 8B Q4 | باید اندازهگیری شود | باید اندازهگیری شود | باید اندازهگیری شود |
| V100 16GB | 8B Q4 | باید اندازهگیری شود | باید اندازهگیری شود | باید اندازهگیری شود |
| P40 24GB | 8B Q4 | باید اندازهگیری شود | باید اندازهگیری شود | باید اندازهگیری شود |
این جدول یک الگوی آزمایش است، نه مجموعهداده تکمیلشده بنچمارک. پیشنهاد میکنیم اعداد واقعی را تنها زمانی منتشر کنید که سختافزار و پیکربندیها آزمایش شده باشند.
7. ساخت یک سرور اقتصادی برای اجرای محلی LLM
علاوه بر عملکرد استنتاج، هنگام نصب کارتهای قدیمیتر Tesla در یک ورکاستیشن یا سرور، باید چند عامل عملی را نیز در نظر گرفت.
خنککاری: هم Tesla P40 و هم بردهای رایج دیتاسنتری Tesla V100 از خنککاری پسیو استفاده میکنند و به جریان هوای شاسی وابستهاند. جریان هوای معمول کیس دسکتاپ ممکن است کافی نباشد.
توان: حداکثر توان برد این کارتهای PCIe حدود 250W است. سیستم باید منبع تغذیه مناسب و اتصالات برق صحیح مخصوص همان مدل را داشته باشد.
سازگاری مادربرد: مطمئن شوید بهجای ماژول SXM2 یک کارت PCIe تهیه میکنید، مگر اینکه سرور شما مشخصاً از SXM2 پشتیبانی کند.
RAM: حافظه کافی سیستم هنگام بارگذاری مدلها یا انتقال لایهها به CPU همچنان اهمیت دارد.
سیستمعامل: لینوکس گزینهای عملی برای ساخت سرورهای اختصاصی استنتاج محلی است، بهویژه هنگام استفاده از llama.cpp و ابزارهای مبتنی بر CUDA.
در نهایت، به یاد داشته باشید که GPUهای قدیمیتر ممکن است نسبت به معماریهای جدیدتر به نگهداری نرمافزاری بیشتری نیاز داشته باشند.
8. جمعبندی نهایی: کدام GPU را باید انتخاب کنید؟
هیچ گزینهای برای همه بارهای کاری هوش مصنوعی محلی برنده مطلق نیست.
| GPU | مناسبترین کاربرد |
|---|---|
| Tesla V100 32GB | توسعهدهندگانی که VRAM بیشتر، پهنای باند بالا و انعطافپذیری برای LLMهای کوانتیزهشده بزرگتر میخواهند |
| Tesla V100 16GB | مدلهای کوچکتر و متوسط که 16GB برای آنها کافی است |
| Tesla P40 24GB | پروژههای اقتصادی که ظرفیت حافظه مقرونبهصرفه را در اولویت قرار میدهند و میتوانند با الزامات سازگاری نرمافزاری سختافزار قدیمیتر کنار بیایند |
برای بسیاری از سیستمهای تکGPU اجرای محلی LLM، Tesla V100 32GB متوازنترین و قویترین گزینه در مجموع میان این سه کارت است، به شرط آنکه قیمت و الزامات سیستم آن منطقی باشند.
کارت V100 16GB همچنان برای بارهای کاری کوچکتر توانمند است. کارت P40 24GB زمانی میتواند مفید باشد که حافظه بیشتر، ارزش پذیرش معماری پردازشی قدیمیتر و عملکرد احتمالاً پایینتر را داشته باشد.
بهترین انتخاب در نهایت به مدل، بار کاری، هزینه برق، قیمت سختافزار و پشته نرمافزاری شما بستگی دارد.
9. پرسشهای متداول
آیا Tesla V100 32GB برای اجرای LLM در سال 2026 مناسب است؟
بله، برای بارهای کاری سازگار. حافظه 32GB HBM2 و پهنای باند بالای آن، این کارت را برای مدلهای زبانی کوانتیزهشده و آزمایشهای محلی هوش مصنوعی مفید میکند. با این حال، باید قدیمی بودن آن و پشتیبانی محدود در نرمافزارهای جدیدتر CUDA را در نظر گرفت.
آیا Tesla P40 24GB بهتر از V100 16GB است؟
بستگی دارد. کارت P40 حافظه بیشتری دارد که ممکن است امکان اجرای کامل مدلهای کوانتیزهشده بزرگتر را روی GPU فراهم کند. کارت V100 پهنای باند حافظه بالاتر و قابلیتهای قویتری در محاسبات با دقت ترکیبی دارد که میتوانند عملکرد مدلهایی را که روی هر دو کارت جا میشوند، بهبود دهند.
آیا میتوانم یک مدل 32B را روی Tesla P40 اجرا کنم؟
برخی مدلهای 32B با کوانتیزهسازی 4 بیتی ممکن است بسته به حافظه واقعی موردنیاز مدل، اندازه زمینه و سربار زمان اجرا جا شوند. پیش از فرض امکان انتقال کامل پردازش به GPU، نیاز VRAM را بررسی کنید.
آیا Tesla V100 از Ollama پشتیبانی میکند؟
معماری V100 در برخی پیکربندیهای Ollama/CUDA پشتیبانی میشود، اما باید سازگاری آن را با نسخه نصبشده Ollama، محیط اجرای CUDA و درایور NVIDIA خود بررسی کنید. نباید پشتیبانی در یک فایل اجرایی فعلی را بدیهی فرض کرد.
آیا میتوانم دو GPU مدل Tesla V100 را با هم ترکیب کنم؟
بله، چارچوبهای استنتاج سازگار میتوانند لایهها یا تنسورهای مدل را میان چند GPU توزیع کنند. با این حال، دو کارت 32GB بهطور خودکار مانند یک GPU با حافظه 64GB رفتار نمیکنند و عملکرد به نحوه توزیع محاسبات و دادهها توسط چارچوب بستگی دارد.
نتیجهگیری
کارتهای Tesla V100 32GB، Tesla V100 16GB و Tesla P40 24GB نشان میدهند چرا ظرفیت VRAM بهتنهایی برای ارزیابی عملکرد GPU در هوش مصنوعی کافی نیست.
شناخت معماری، پهنای باند حافظه، کوانتیزهسازی مدل و سازگاری نرمافزاری به شما کمک میکند سختافزاری انتخاب کنید که با بار کاری واقعی شما تناسب داشته باشد.
در Effecsa GPU، تمرکز ما بر آسانتر کردن درک سختافزار GPU، استقرار محلی LLM و زیرساخت هوش مصنوعی از طریق راهنماهای فنی، مقایسههای شفاف و بنچمارکهای تکرارپذیر است.
برای آشنایی بیشتر با سختافزار هوش مصنوعی، سرورهای استنتاج محلی و انتخاب GPU مناسب پروژههای خود، Effecsa GPU را کاوش کنید.
منابع فنی
1. دیتاشیت رسمی NVIDIA Tesla V100 2. دیتاشیت رسمی NVIDIA Tesla P40 3. قابلیت محاسباتی NVIDIA CUDA — GPUهای قدیمی 4. ماتریس سازگاری ابزار توسعه CUDA و درایور NVIDIA 5. مستندات بنچمارک llama.cpp
بهروزرسانیشده در اکتبر 2026. مشخصات، ارقام منتشرشده توسط سازنده هستند. ارزیابیهای سازگاری مدل صرفاً نمونهای هستند و جایگزین اندازهگیریهای تکرارپذیر عملکرد نمیشوند.
پرسشی درباره زیرساخت هوش مصنوعی خود دارید؟
با کارشناسان ما صحبت کنید
برای زیرساخت هوش مصنوعی خود مشاوره شخصی بگیرید.
مشاوره با ما →